CGC2026|张泽华:以超节点内存池化支撑搜广推低时延决策
2026-10-30
以下文章来源于微信公众号——全球计算联盟GCC
GCC NEWS
2026全球计算大会(CGC2026)上,京东算法总监张泽华带来《互联网搜广推场景超节点技术应用新范式》主题分享,介绍超节点在京东相关业务中的规模化应用,探讨搜索、广告、推荐向生成式与Agentic演进过程中的架构需求。他指出,面向毫秒级响应的在线业务,算力建设需要同时关注数据访问、跨服务通信与业务编排,通过内存池化和低时延互联,让更多计算在业务时限内形成有效产出。
图:京东算法总监张泽华作主题演讲
搜广推算法演进与毫秒级业务挑战
张泽华从搜广推的业务本质切入:搜索、广告、推荐都需要在海量信息中找到与用户需求相关的小集合,再完成排序与呈现。用户意图、查询表达和系统存储的信息之间存在差距,信息结构化程度、相关性判断和查询时效共同影响服务体验。随着算法不断演进,如何在有限时间内完成更复杂的检索与决策,成为架构设计必须回应的问题。
他介绍,搜广推正从传统的召回、粗排、精排等多阶段链路,逐步走向生成式算法对单个环节的替代、多环节融合,以及端到端生成式推荐。进一步引入Agentic后,系统还需要支持任务规划、工具调用和多步骤协同,实时推理、业务编排与算力效率的挑战随之加大。
以京东广告业务为例,演讲展示的全链路耗时为300毫秒,其中模型推理仅有20—100毫秒;日请求量达到千亿级。这意味着,复杂算法需要在极短的时间窗口内完成计算,同时满足高并发和稳定服务的要求。生成式推荐虽然升级了算法能力,仍需遵守在线业务原有的时延约束。
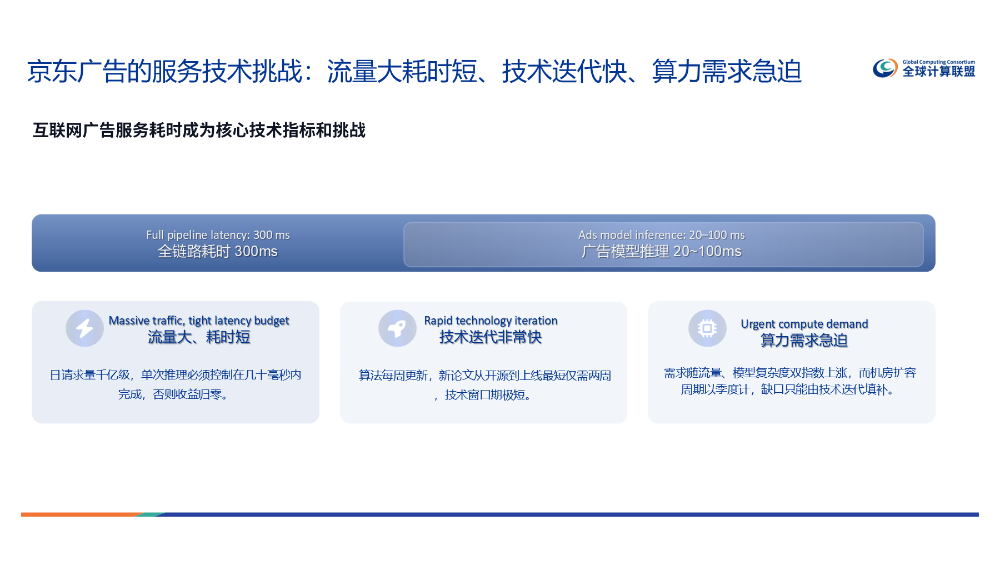
图:京东广告业务的时延约束与技术挑战
通过内存池化改善数据访问与跨节点通信
在张泽华看来,增加GPU、NPU数量,并不能自动消除业务链路中的等待。搜广推系统由多个服务环节组成,多跳调用、并行请求的扇出与排队、数据在主机和加速器之间的搬移,以及跨服务状态一致性,都可能影响请求能否按时完成。当数据与通信成为瓶颈时,新增算力也难以充分转化为业务产出。
针对这些问题,他介绍了以通算超节点组织大规模内存资源的思路,通过内存借用与内存共享两项基础能力,减少数据搬移和通信开销。内存借用将邻居节点的空闲物理内存映射给本节点应用,用于扩展可用容量;内存共享则将同一物理内存区域映射给多个使用者,使多个节点能够访问共享数据。
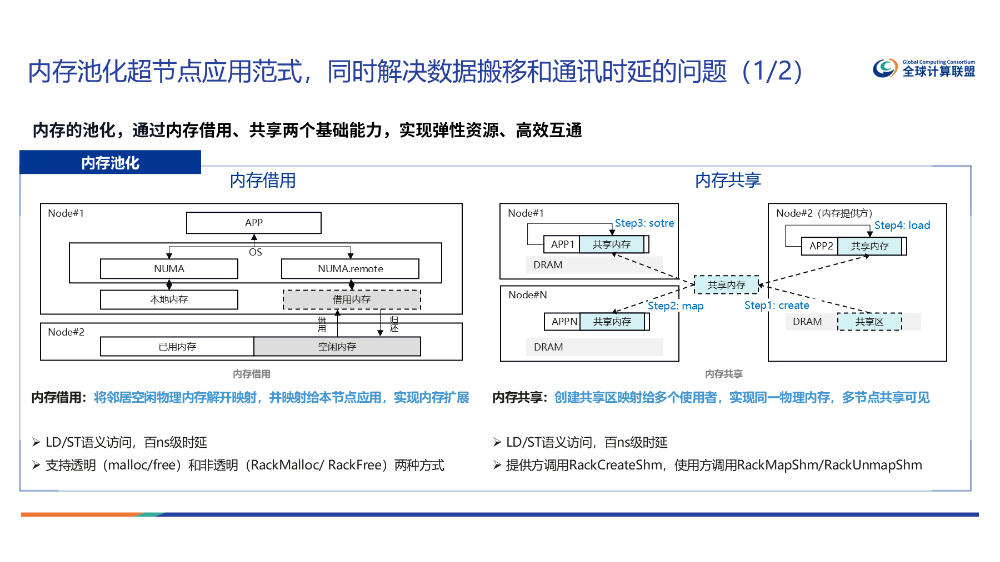
图:内存借用与内存共享的实现思路
这一路径把原本分散在服务器中的内存组织为可协同使用的资源池,让数据更接近需要使用它的计算环节。张泽华介绍,除搜广推外,相关能力还可用于数据库与服务弹性部署、云原生应用、RPC通信以及模型训推,分别支撑容量扩展、带宽利用、直接数据交换和缓存共享等需求。
KV Cache与RPC通信的时延优化
KV Cache是演讲重点介绍的应用之一。张泽华展示了以鲲鹏超节点构建300TB共享内存池的方案,将缓存访问从片上内存、本地DDR、本地SSD、远端Redis等多层路径,调整为片上内存与本地共享DDR池的两级组织方式。通过大带宽、低时延的灵衢互联,相关方案旨在降低跨节点缓存获取的开销,支持更多数据在业务时限内参与计算。
在演讲展示的TCP与灵衢方案对比中,以8MB请求的并发访问为例,跨节点TP99时延降低85%以上;在64MB序列长度条件下,TP99时延约降至TCP方案的1/16。这些对比体现了共享内存池在特定请求规模和并发条件下改善缓存访问时延的效果。
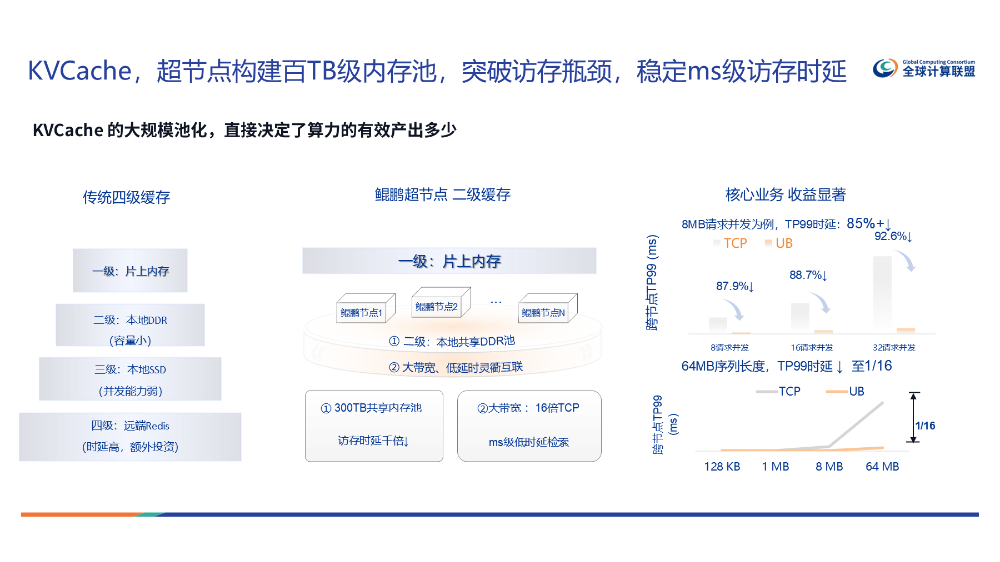
图:KV Cache池化架构及不同条件下的时延对比
RPC通信则关系到多个业务服务之间的数据交换。传统路径需要经过网络协议栈处理和数据传输,相关开销会随着调用链累积。张泽华介绍,通过远端内存寻址与直接访问,并利用灵衢降低协议处理开销,可以缩短跨服务的数据获取路径。在其展示的不同报文大小对比中,相较TCP方案,RPC的P99时延降低40%以上,其中较大报文的时延改善更为明显。
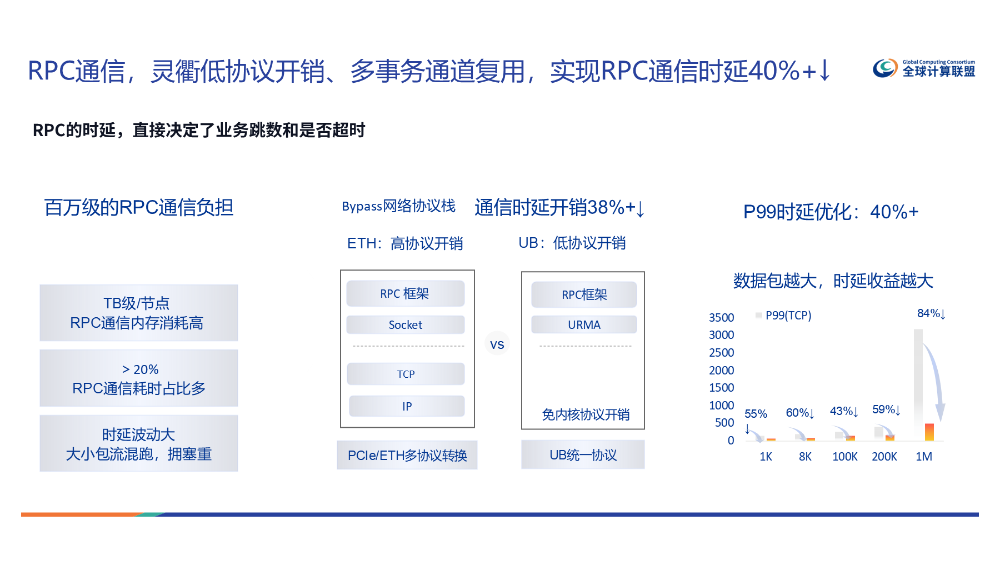
图:RPC通信路径与不同报文大小下的P99时延对比
支撑Agentic应用的状态共享与任务协同
随着Agentic进入业务流程,计算基础设施需要支持的不只是单次模型调用。一个任务可能依次经历规划、工具调用、检索、执行和结果汇总,期间产生大量上下文、中间结果与历史状态。多模型、多步骤协同使跨环节的数据流转更加频繁,也对任务隔离和沙箱管理提出要求。
张泽华介绍,通过全局统一内存池保存这些状态,计算节点可以直接访问所需数据,减少跨步骤的重复搬运与加载。据其介绍,相关应用可支持每秒约1万次沙箱内Agentic任务。在电商生产场景中,智能体的价值体现在持续完成状态选择、打分、出价与工具调用等决策,基础设施需要为这些高频协同提供低时延支撑。
在规模扩展中关注有效计算产出
围绕超节点的规模边界,张泽华表示,京东正在探索向万级物理节点扩展的组织方式。这一方向既涉及单个超节点内部的紧耦合扩展,也涉及跨超节点的网络化互联,需要同时处理Scale-Up与Scale-Out层面的工程问题,包括供电散热、物理传输时延、多跳排队以及跨域容灾等。
规模扩展最终仍要回到业务能否获得有效计算产出。张泽华强调,CPU承担的检索、过滤、特征拼装、预算与频控等工作,以及通信系统对数据的及时传递,是加速器完成业务计算的重要前提。生成式算法和智能体的发展,也没有消除对历史状态、缓存与候选信息的检索需求。
在算力效率评价上,他提出结合业务服务等级协议(SLA)的时延要求理解“实际MFU”:关注在时延预算内完成、形成有效决策并进入业务流程的计算。对于搜广推和决策型Agent,超时完成或未被业务使用的计算,难以产生相应价值。他认为,超节点的应用价值,需要落实到计算、内存与通信的协同中,让更多计算在业务时限内转化为有效决策。
拓展阅读