CGC2026|闫守孟:模运算加速芯片——以万倍加速突破全同态密算应用鸿沟
2026-11-07
以下文章来源于微信公众号——全球计算联盟GCC
GCC NEWS
2026 全球计算大会(CGC2026)主论坛上,蚂蚁密算CTO闫守孟带来《模运算加速芯片:以万倍加速突破全同态密算应用鸿沟》主题分享,介绍了密态计算领域的最新进展,以及蚂蚁密算MPU H1全同态密算芯片的架构设计、性能表现与应用实践。(本文根据现场发言整理,略有删减)
图:蚂蚁密算CTO闫守孟作主题演讲
一、AI时代的数据两难
AI时代,数据与算力是两大核心要素。任何单一机构都难以拥有充分的数据,数据唯有融合流通,才能充分释放价值;但数据具有可复制性,一旦复制,价值随之消减,更会引发安全与合规风险。融合需求与风险防范由此形成两难,给实际应用带来诸多挑战。
一个直观的思路是:若能在密态下直接完成计算、挖掘数据价值,则是相对理想的解法。传统的存储加密、传输加密均属这一方向的努力,而计算环节的加密,仍有待进一步突破。
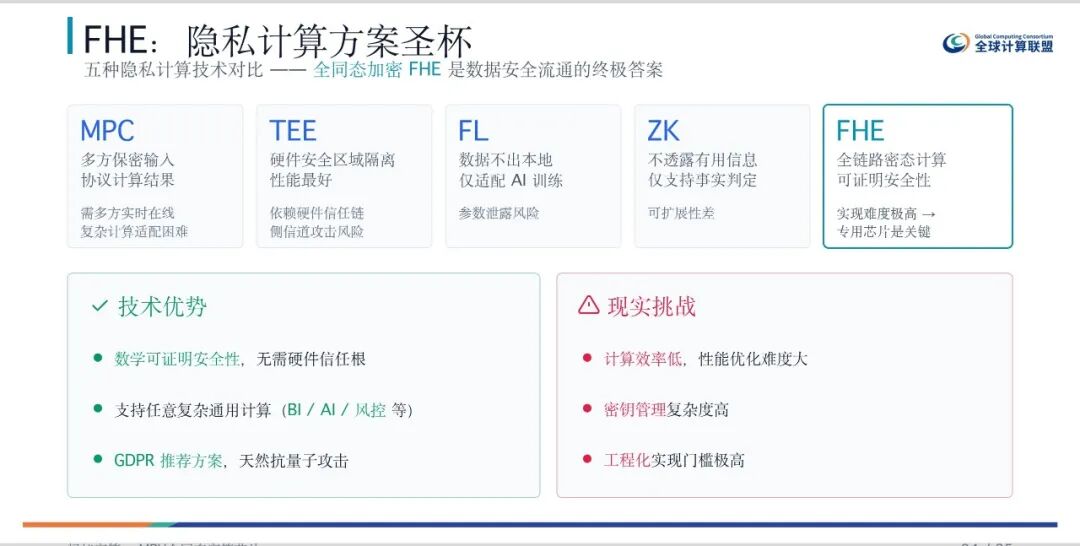
二、FHE:隐私计算的“圣杯”
业界已有多种技术路径。可信执行环境(TEE)依赖硬件,性能较好,但安全性难以清晰论证;联邦学习等算法路线同样缺乏可证明安全性。MPC、ZK、FHE三者可证明安全,但MPC需多方协同部署、落地复杂;ZK更适用于逻辑判定类运算;FHE则是较新的隐私保护计算“圣杯”技术——既可证明安全性,又实现全链路密态保护,且具备抗量子攻击能力。
三、万倍鸿沟:为什么需要专用芯片
FHE已发展至工程化阶段,但密态不解密直接计算的性能天然偏弱,并伴随数据膨胀问题。历经多年发展,FHE虽已基本具备工程落地条件,现有落地规模仍较为有限,主要瓶颈在于同态计算性能——与明文计算相比,仍存在4至6个数量级的差距。
数据膨胀与计算膨胀叠加,还涉及大量数据搬运。若以芯片或加速器承载FHE,计算、存储与数据交换均需专门设计。
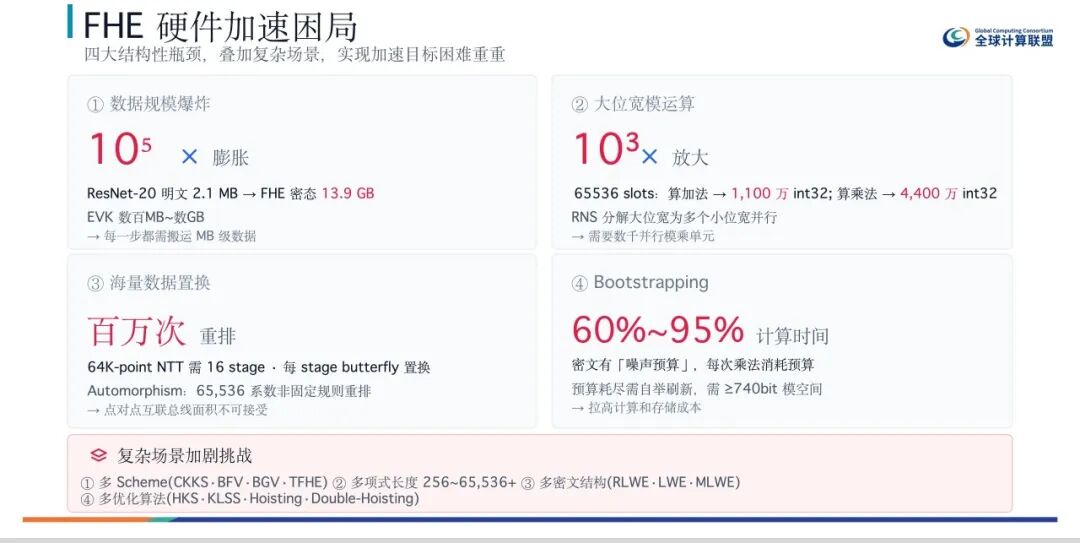
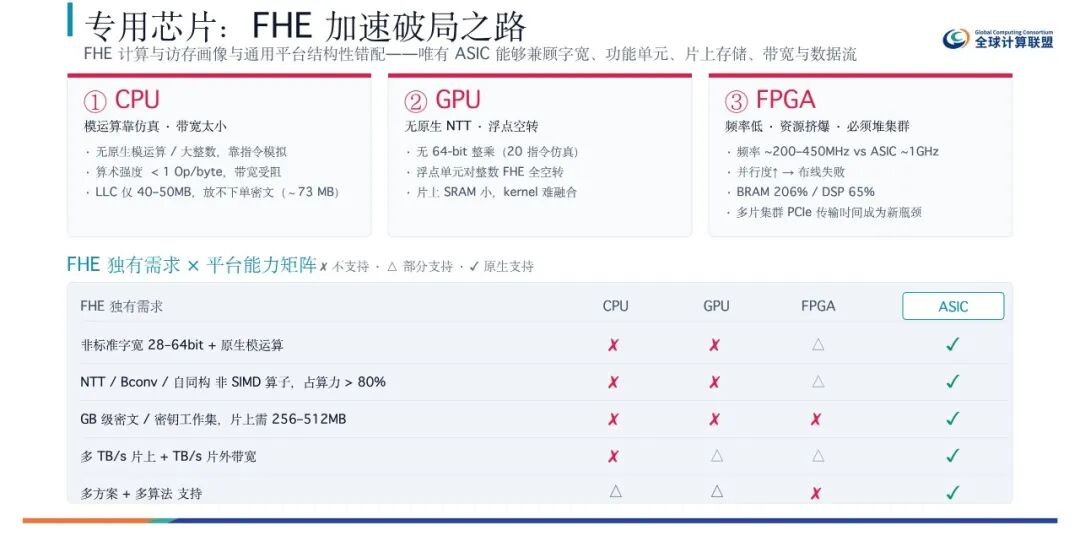
目前业界已有基于GPU、FPGA等通用硬件加速FHE的尝试,蚂蚁密算亦开展了大量相关研究。但闫守孟指出,GPU与FPGA并非为该领域设计的专用硬件,在诸多方面难以充分支撑FHE密态计算,研制专用芯片因此尤为必要。
四、MPU H1:为模运算而生的芯片
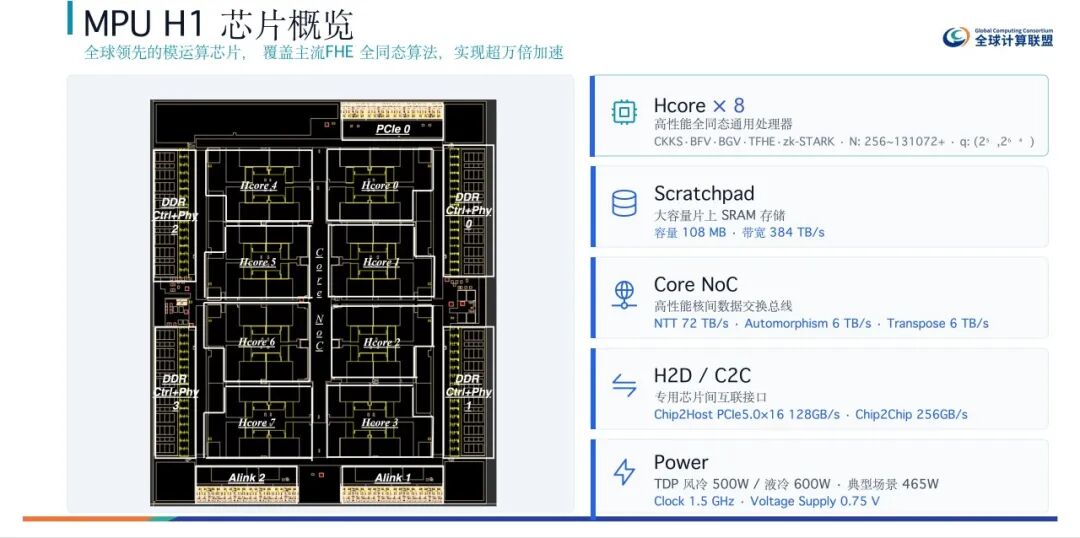
MPU H1正是蚂蚁密算近年来的核心成果——采用多核架构,配备相对大容量的片上核,支持Scale out扩展。其模运算核为基于RISC-V扩展的通用模运算处理器核,支持编程,指令集约15条,可覆盖全同态领域的多种算法,乃至零知识证明等非全同态算法。处理器核内置专门加速单元,支持模加、模乘及转置、自同构等操作。
多核层面采用弹性架构,可根据任务负载参数绑定物理核与逻辑核,绑定完成后,内部数据切分由硬件自动完成。
其实现相对CPU上万倍、即四个数量级以上加速的核心要素在于片上网络——针对自同构与转置操作,均设计了专门的数据交换网络。
存储架构则采用相对简化的设计:一方面取消Cache,由SRAM直连片外存储,并依托片上网络尽量减少片外访问;另一方面采用NUMA拓扑,降低数据竞争。
多颗芯片还可直接互连,或经由专门设计的交换机组网,构成更大规模的节点乃至超节点。
五、全栈软件与实测性能
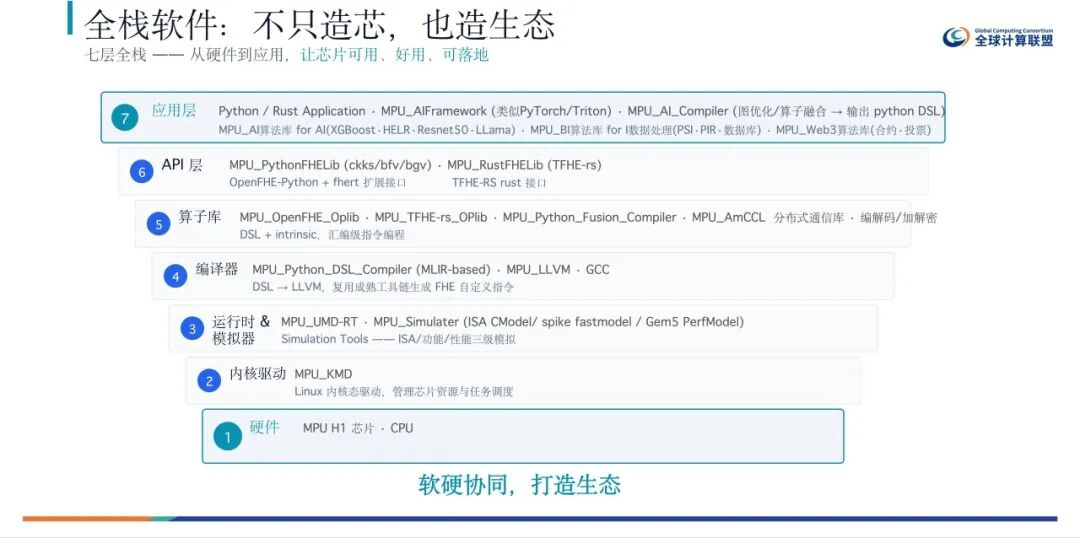
围绕该芯片,蚂蚁密算构建了完整的专用软件栈。闫守孟将其比作“密态计算领域的英伟达GPU”——正如GPU依托软件栈持续放大生态,蚂蚁密算也从零搭建了覆盖全链路的软件体系。
相较于其他领域的同类芯片,MPU H1的突出特点是灵活性:英特尔的同类芯片仅支持少数几种算法且难以扩展,MPU H1则兼容现有绝大多数算法并面向未来算法开放,算法参数选取亦十分灵活,各类参数组合均可支持。性能方面,MPU H1相对CPU实现四个数量级加速;相对英特尔同类芯片,加速比可达10倍。
六、场景落地:从密态医疗到Web3
在具体负载上,以人脸识别为例,MPU H1单卡运行ResNet-18的密态推理时延为47.1毫秒,8卡运行ResNet-50为86.3毫秒,密态CNN推理由此首次进入可用时延区间。
大模型方面,蚂蚁密算亦在探索密态支持:数据以加密形态传入,云端推理全程不解密,为健康信息、企业内部敏感文件等场景提供安全保障。目前密态推理尚难支持明文级别的超大模型,但运行LLaMA3-8B(80亿参数)时每秒可生成5个以上Token,在对吞吐量相对容忍的场景下已具备可用性。
该类芯片主要面向医疗、金融及部分政务等对数据安全要求极高的场景。以某国际药企为例:其需将自研模型与中国医院数据融合开展药物效果分析,而模型与数据均高度敏感。蚂蚁密算以全同态加密结合MPU芯片加速推理,原先50万样本的推理需约300小时,如今约97秒即可完成。
此外,蚂蚁密算也在探索更多应用方向。Web3领域是其中之一:区块链上数据均为明文,若在其上开展金融业务,策略与交易活动将完全暴露,可能招致“三明治攻击”,同态加密可提供安全增强。国外公司Zama采用GPU加速路线,蚂蚁密算则以专用芯片实现——单颗芯片约可达成8张H100的算力效果。
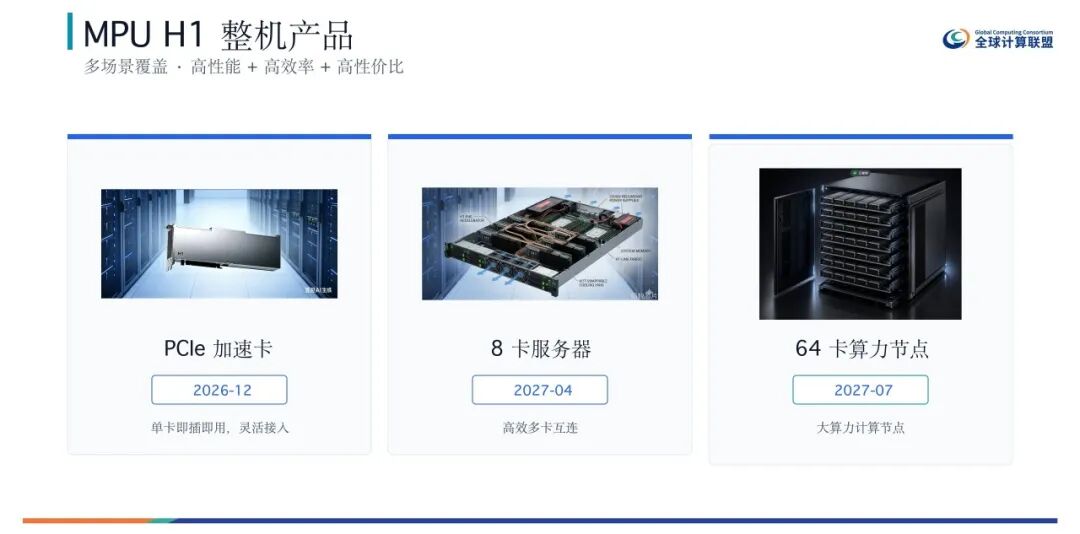
演讲最后,闫守孟展示了产品形态。他表示,期待依托GCC平台,与更多企业及科研院所深化合作,共同迎接密态计算时代的到来。