CGC2026|蒋铭:Peerium架构设计理念与系统创新,面向超大模型的算力演进
2026-10-30
以下文章来源于微信公众号——全球计算联盟GCC
GCC NEWS
在2026全球计算大会(CGC2026)现场,华为Fellow、计算架构与设计部部长蒋铭先生,带来主题分享《Peerium架构设计理念与系统创新》。演讲剖析超大模型发展下大规模算力集群的同步、互联、部署难题,提出Peerium系统架构,探讨如何让百万卡规模集群可以像一台计算机一样运行。
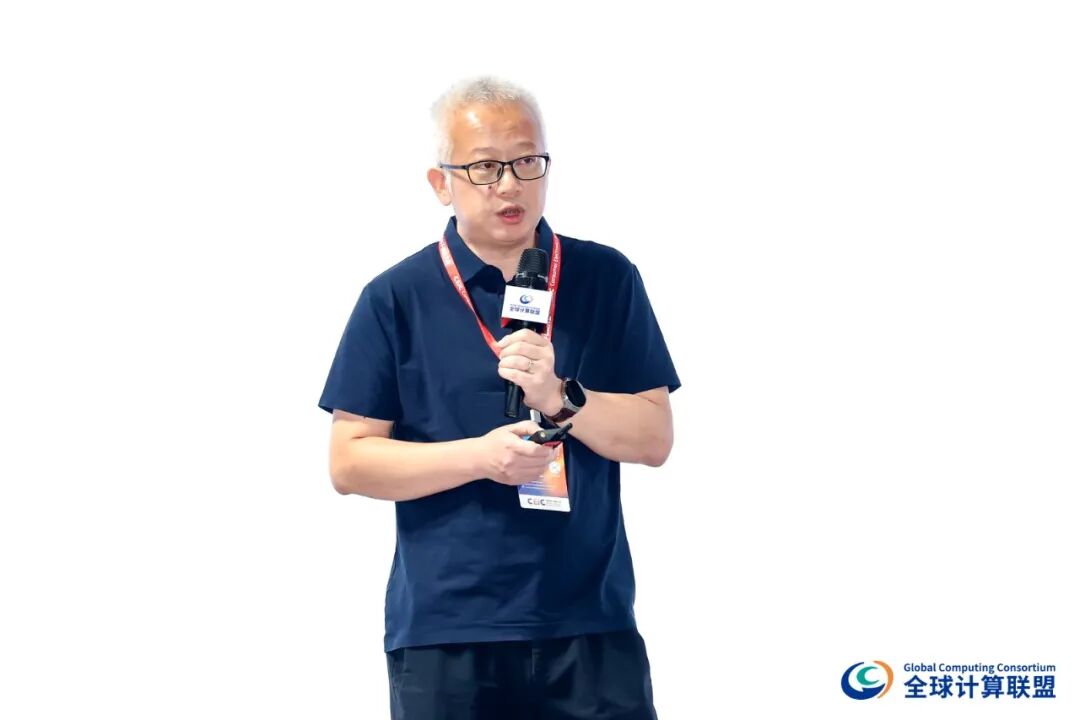
图:华为技术有限公司Fellow、计算架构与设计部部长蒋铭作主题演讲
大模型演进趋势与算力挑战
大模型计算需求持续动态演进,立足架构层面统筹设计、推进系统创新,已然成为AI产业高度关注的核心命题。蒋铭表示,全球大模型Scaling Law正加速发展,北美模型已达10T–15T、向20T–50T演进,中国模型突破万亿,向3T-10T演进。但在规模扩张过程中,如何提升计算效率,让算力有效支撑大模型发展,是当下亟待破解的关键挑战。
业界认为2030年模型规模将由10T进化至100T,训练算力需求推测提升100倍,需要百万卡级别及以上的并行集群,才能支撑相应训练任务;推理侧算力成本推测提升10–20倍,时延也面临10–20倍压力。
华为提出Peerium架构,旨在为产业提供全新思路与技术路径,应对超大模型时代训练、推理所面临的一系列难题。
Peerium架构核心思路:面向超大规模集群的并行范式
蒋铭介绍,Peerium架构的核心,是“让百万处理器成为一台计算机”。AI训练与推理负载属于高度耦合的单体任务,松散化的集群架构会在通信交互环节产生巨额开销
以100T模型训练示例为例,传统全局BSP同步模式下,每卡每秒需2000万次同步,几乎无法执行有效计算。
图:左:经典BSP 右:Peerium嵌套递归 BSP方案
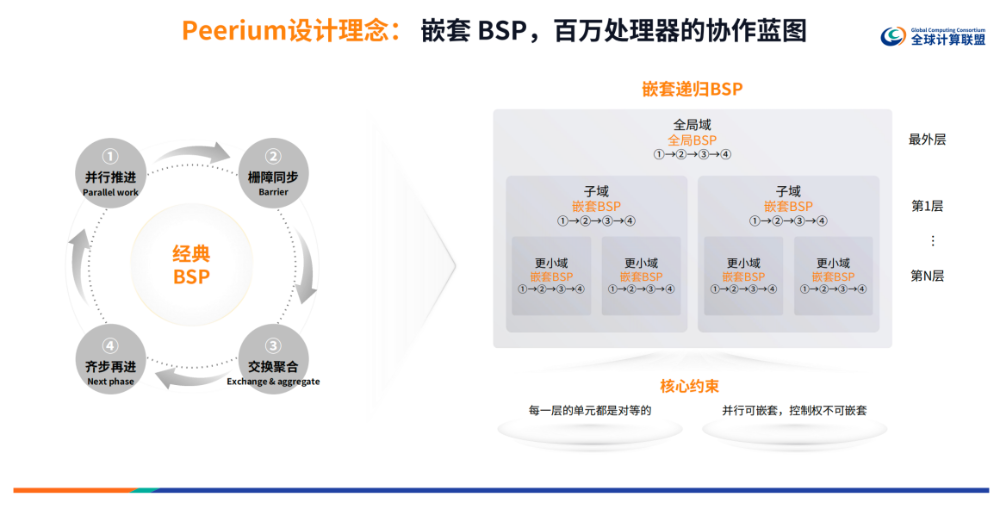
Peerium架构通过嵌套 BSP 分层并行,将同步域拆解成多个DP域,DP域又拆解成多个EP域,EP域之间构成PP域,或者更复杂的一些并行方式,比如DP或CP域等,核心的特点是尽可能降低局部域的规模。基于嵌套BSP架构设计,可以将千万级的数据同步次数有效降到千级。
灵衢:实现Peerium架构的关键互联协议
Peerium基于灵衢,在6个维度构建连续性梯度:协议归一、内存统一编址、平等协同、铜近光远、物理稀疏逻辑紧密、高可用性
第一,协议归一:超节点内基于UB-C互联,超节点间基于UB-G互联,PCIe、RoCE、IB、ETH等10+协议归一
第二,内存统一编址。超节点全局内存统一编址,load/store指令级访问,一跳直达。
第三,平等协同。所有组件(CPU/NPU/SSD/DPU)拥有全局唯一标识EID,通过UMMU实现硬件级内存访问鉴权。
第四,铜缆近距、光纤远距。NPO光引擎与主芯片近封装集成,超节点内0光模块。
第五,物理稀疏、逻辑紧密。节点物理稀疏分布,通过两层CLOS四平面组网实现逻辑紧密集成。
第六,高可用性。分层可靠机制,物理层动态升降Lane+光模块2+2备份,链路层重传。
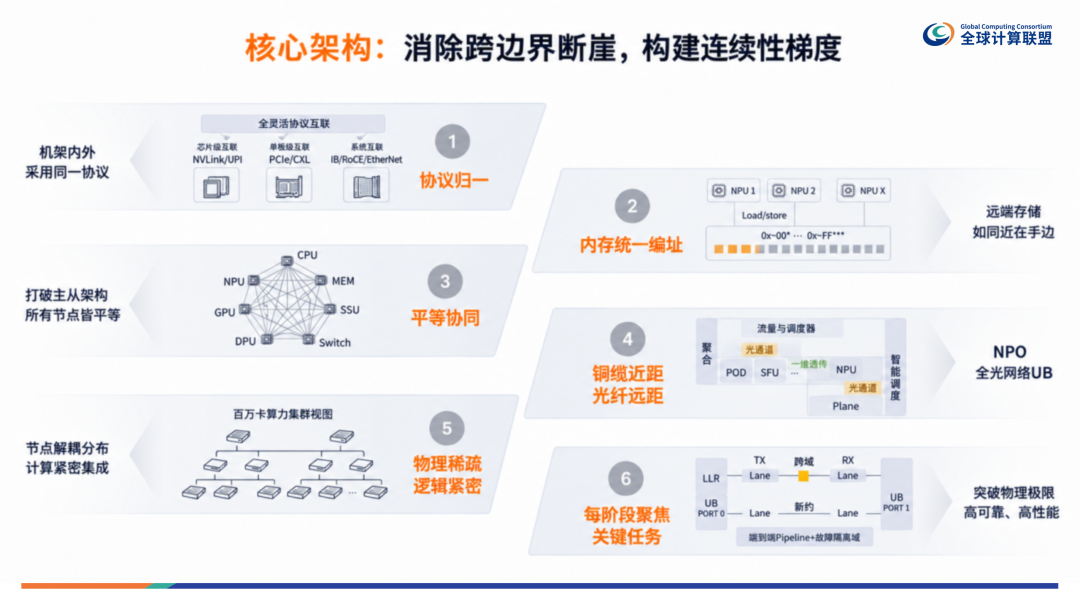
图:UnifiedBus 统一总线,面向多样化数据访问,
优化大模型推理时延
产业开放共建
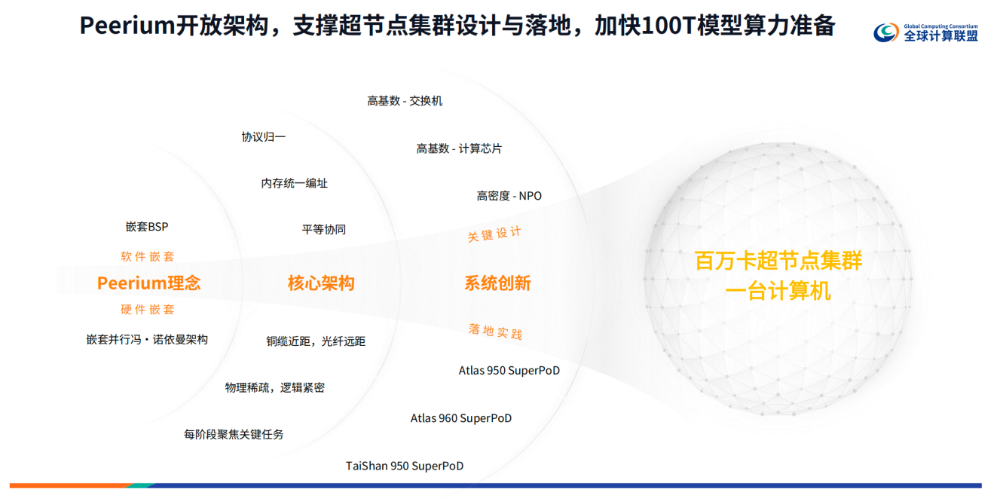
图:Peerium 架构愿景,构建百万卡超节点集群,如同单台计算机运行
Peerium架构的应用价值并不局限于AI智算场景。在通算、推荐搜索等业务场景,超节点同样可以释放技术价值。面向Agent时代,节点间壁垒被打通之后,跨大规模域的信息流转、Agent沙箱的快速创建释放与弹性扩缩,均可获得底层系统能力支撑。
蒋铭表示,华为愿与业界伙伴持续完善Peerium架构,支撑超节点集群设计与落地,助力产业加速迈向100T模型时代,让算力无处不在,让智能无所不及。
拓展阅读